HTTP 커넥션 풀 고갈 트러블슈팅 — EntityUtils.consume() 한 줄의 비밀
1. 들어가기 전
이슈 현상
외부 API 장애 발생 시 Apache HttpClient 커넥션 풀이 빠르게 고갈되어, 정상 API 호출까지 연쇄적으로 실패하는 현상
문제 정의
외부 API 호출 코드에서 응답이 200일 때만 EntityUtils.toString() 으로 본문을 읽고, 비-200 응답에서는 본문을 읽지 않은 채 응답을 닫는 구조.
이때, 외부 API가 일시적으로 5xx/4xx 응답을 반복적으로 반환하기 시작하자 짧은 시간 안에 커넥션 풀이 고갈되었고, 결국 장애와 무관한 다른 외부 API 호출까지 ConnectionPoolTimeoutException 으로 실패하는 연쇄 장애가 발생.
2. 문제 재현 및 로그 (Reproduction & Logs)
수정 전 코드 (문제가 된 코드)
public static String sendGetRequest(String url, Map<String, String> headers) {
    CloseableHttpResponse response = null;
    try {
        HttpGet request = new HttpGet(url);
        headers.forEach(request::addHeader);
        response = httpClient.execute(request);
        int statusCode = response.getStatusLine().getStatusCode();
        if (statusCode == 200) {
            return EntityUtils.toString(response.getEntity(), StandardCharsets.UTF_8);
        }
        // 비-200 응답인 경우: body를 읽지 않고 그대로 빠져나갑니다.
    } catch (SSLException e) {
        return "";
    } catch (Exception e) {
        log.error("sendGetRequest fail : {}", url, e);
    } finally {
        closeResponse(response);
    }
    return "";
}
에러 로그 (일반 예시)
org.apache.http.conn.ConnectionPoolTimeoutException: Timeout waiting for connection from pool
    at org.apache.http.impl.conn.PoolingHttpClientConnectionManager.leaseConnection(...)
    at org.apache.http.impl.conn.PoolingHttpClientConnectionManager$1.get(...)
    at org.apache.http.impl.execchain.MainClientExec.execute(...)
    at org.apache.http.impl.execchain.ProtocolExec.execute(...)
    at org.apache.http.impl.execchain.RetryExec.execute(...)
    at org.apache.http.impl.execchain.RedirectExec.execute(...)
    at org.apache.http.impl.client.InternalHttpClient.doExecute(...)
    at ApiClient.sendGetRequest(ApiClient.java)
    ...
기대 결과
외부 API가 어떤 상태 코드를 반환하든, 사용한 커넥션은 풀에 정상적으로 반환되어 다음 요청에서 재사용되어야 합니다. 외부 API의 장애가 다른 API 호출에 영향을 주어서는 안 됩니다.
3. 원인 분석 (Root Cause Analysis)
이번 문제의 본질은 단순히 "커넥션 풀이 작아서"가 아니라, 응답 본문을 읽지 않으면 Apache HttpClient가 커넥션을 풀에 되돌려놓지 못한다는 점에 있습니다. 왜 그런지 TCP 레벨부터 차근차근 따라가 보겠습니다.
3-1. 배경 — TCP 연결과 Keep-Alive
HTTP 통신은 TCP 위에서 동작합니다. 새로운 TCP 연결을 맺으려면 3-way handshake 과정을 거쳐야 합니다.
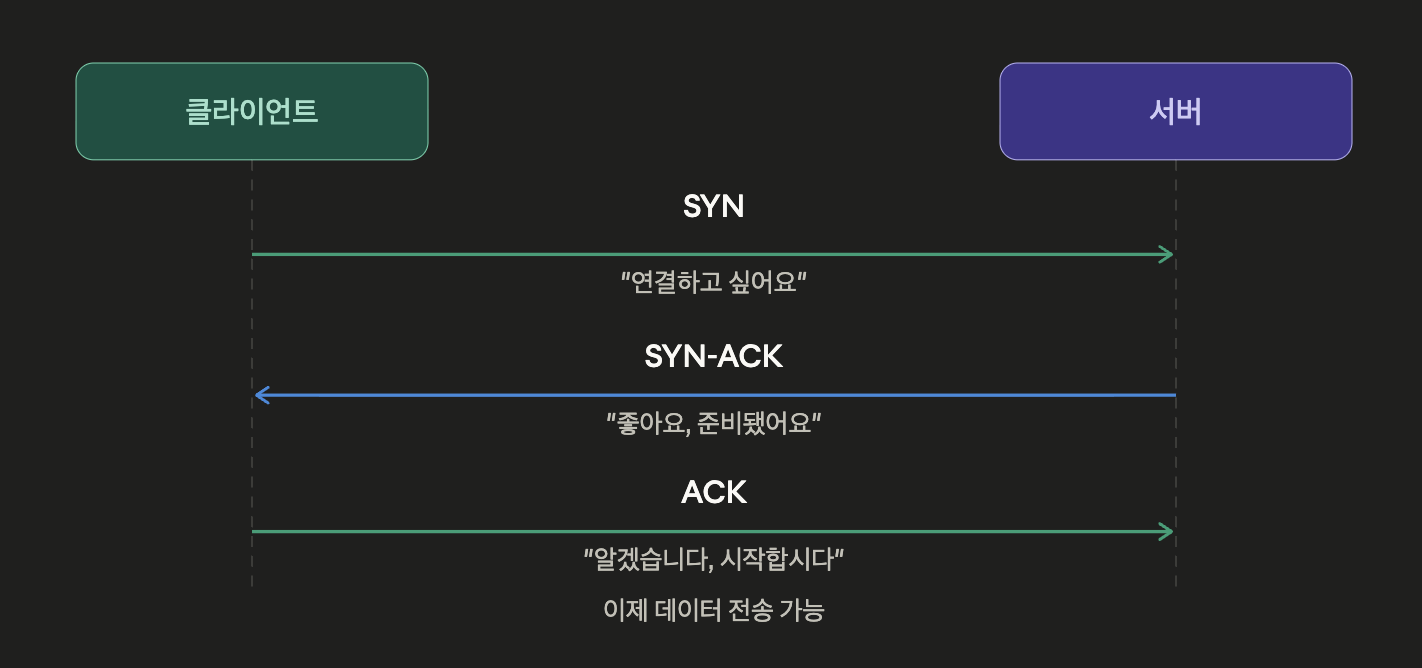
이 3단계는 네트워크 왕복 시간(RTT)만큼의 비용이 듭니다. 매 HTTP 요청마다 이 과정을 반복하면 큰 낭비입니다.
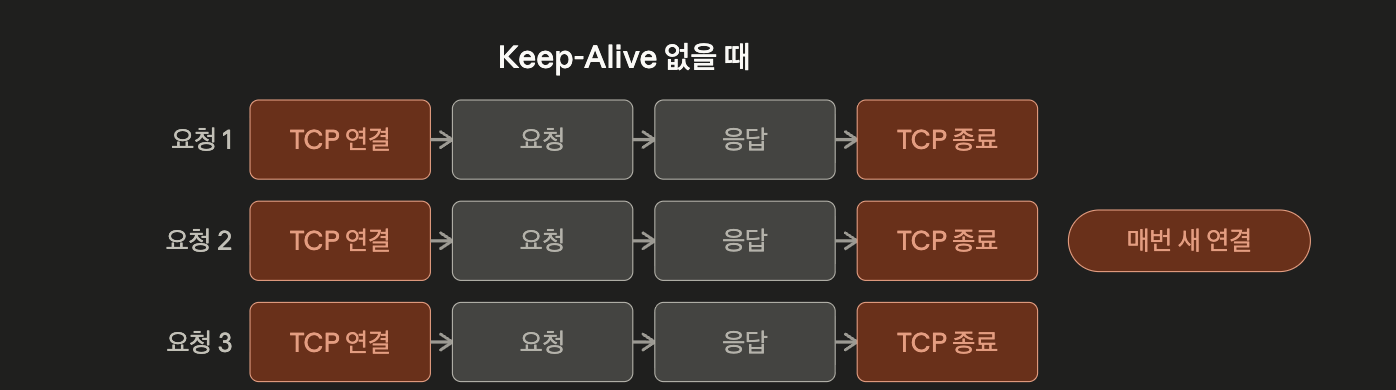
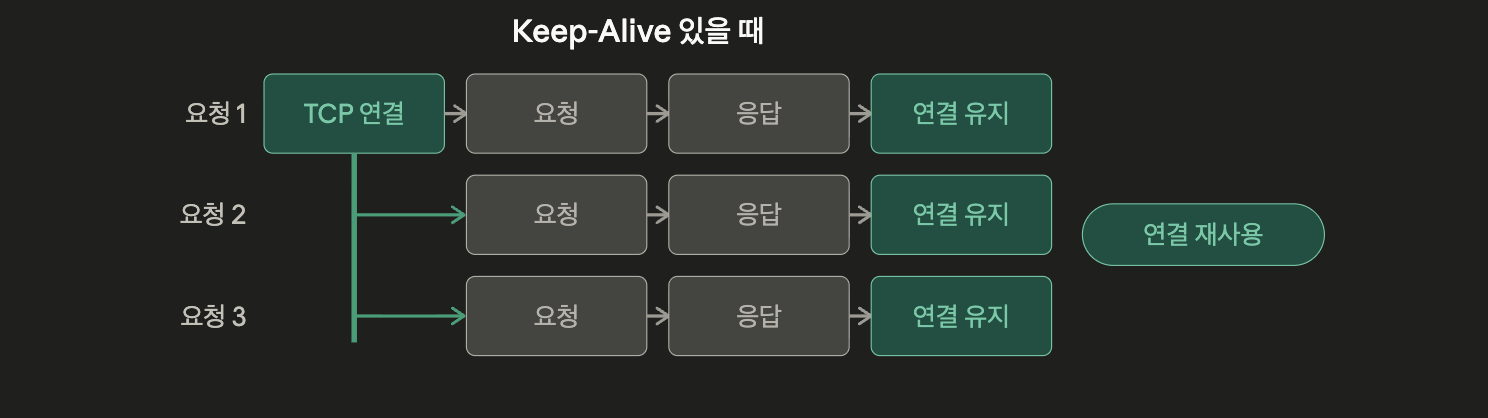
이를 막기 위해 HTTP/1.1은 기본적으로 Keep-Alive 동작을 사용합니다. 한 번 맺어둔 TCP 연결을 끊지 않고 여러 요청에 재사용하는 방식입니다.
1) Keep-Alive 없을 때
2) Keep-Alive 있을 때
3-2. 커넥션 풀 동작 방식
단일 TCP 연결은 한 번에 요청 하나만 처리할 수 있습니다. 고트래픽 서버에서는 여러 커넥션을 미리 만들어 두고 풀(Pool)로 관리합니다. Apache HttpClient에서는 PoolingHttpClientConnectionManager 가 이 역할을 합니다.
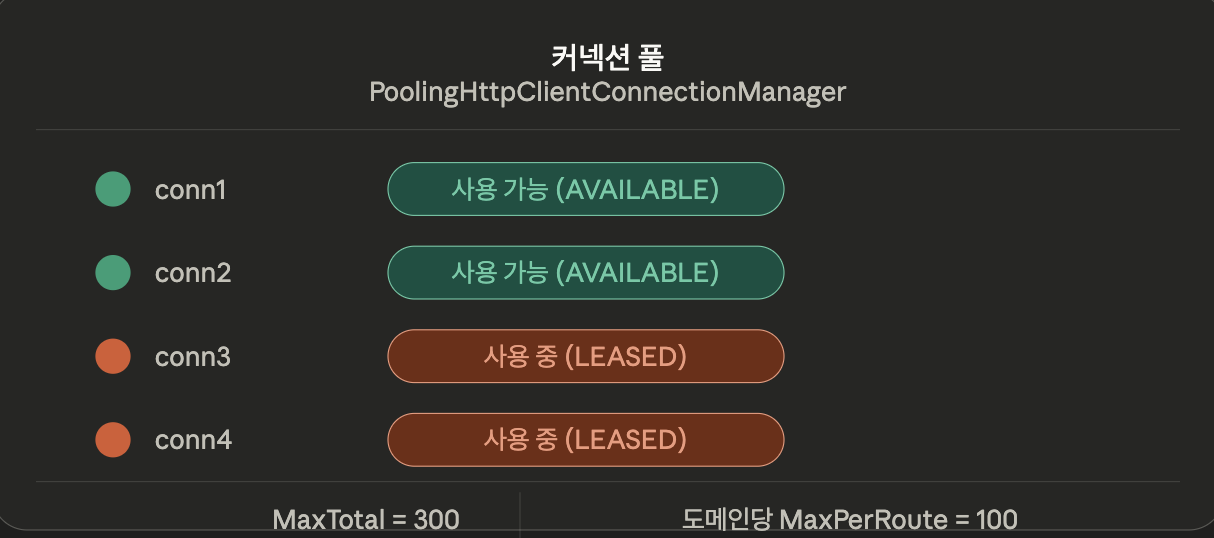
요청 처리 흐름은 다음과 같습니다.
- 풀에서
AVAILABLE상태인 커넥션 하나를 가져와LEASED로 바꿉니다. - 요청을 보내고 응답을 받습니다.
- 커넥션을 다시
AVAILABLE로 바꿔 풀에 반환합니다.
문제는 3번 단계가 언제 일어나는지 입니다. 응답을 받았다고 자동으로 반환되는 것이 아니라, 특정 조건을 만족해야 풀에 돌아갑니다.
3-3. TCP 스트림의 구조와 "다음 응답 시작점" (핵심)
여기서부터가 핵심입니다. HTTP 응답이 TCP 스트림에서 실제로 어떻게 생겼는지 봐야 합니다.
TCP 스트림 (바이트의 연속)
─────────────────────────────────────────────────────→

[HTTP 응답 헤더]          [HTTP 응답 Body]
HTTP/1.1 500 Error\r\n   {"error": "internal"}\r\n
Content-Length: 24\r\n
\r\n
↑                        ↑                          ↑
헤더 끝                  body 시작                  body 끝
Keep-Alive 환경에서는 같은 TCP 연결로 여러 요청을 보내기 때문에 응답이 연속해서 흘러옵니다.
TCP 스트림
────────────────────────────────────────────────────────────────→

[응답1 헤더] [응답1 Body] [응답2 헤더] [응답2 Body] [응답3 ...]
             ↑           ↑
          body 끝    다음 응답 시작
여기서 중요한 점은 TCP는 그냥 바이트의 흐름 이라는 것입니다. "여기서부터 응답 2가 시작합니다" 라고 표시해 주는 구분자는 없습니다. 이전 응답의 body를 끝까지 다 읽어야만 다음 응답이 어디서 시작하는지 알 수 있습니다.
즉, 현재 응답의 body를 읽지 않으면 클라이언트는 스트림 포인터가 어디에 있는지 정확히 알 수 없게 됩니다. 그 상태로 같은 커넥션을 재사용하면 다음 요청의 응답이 이전 응답의 body와 뒤섞여 버립니다. 이는 데이터 정합성에 치명적입니다.
3-4. Apache HttpClient의 lazy body 읽기
httpClient.execute(request) 를 호출하면 내부적으로 다음과 같은 일이 일어납니다.
httpClient.execute(request)
    │
    ├─ 1. 커넥션 풀에서 커넥션을 획득합니다.
    │       풀이 비어있으면 connectionRequestTimeout 동안 대기합니다.
    │
    ├─ 2. TCP 스트림으로 HTTP 요청을 전송합니다.
    │
    ├─ 3. 응답 헤더만 읽습니다 (statusCode, Content-Length 등).
    │       이때 반환되는 response 객체의 entity 는 아직 읽지 않은 스트림을 가리킵니다.
    │
    └─ 4. (응답 body는 여전히 TCP 스트림에 남아 있는 상태로 리턴됩니다.)
즉 execute() 가 리턴된 시점의 스트림 상태는 다음과 같습니다.
TCP 스트림
────────────────────────────────────────────────→

[응답 헤더 ✅읽음] [응답 Body ❌아직 안 읽음]
                   ↑
           현재 스트림 포인터 위치
### execute() 리턴 직후, TCP 스트림 상태.
- TCP 포인터는 body(어직 미읽음) 앞에 위치된다.
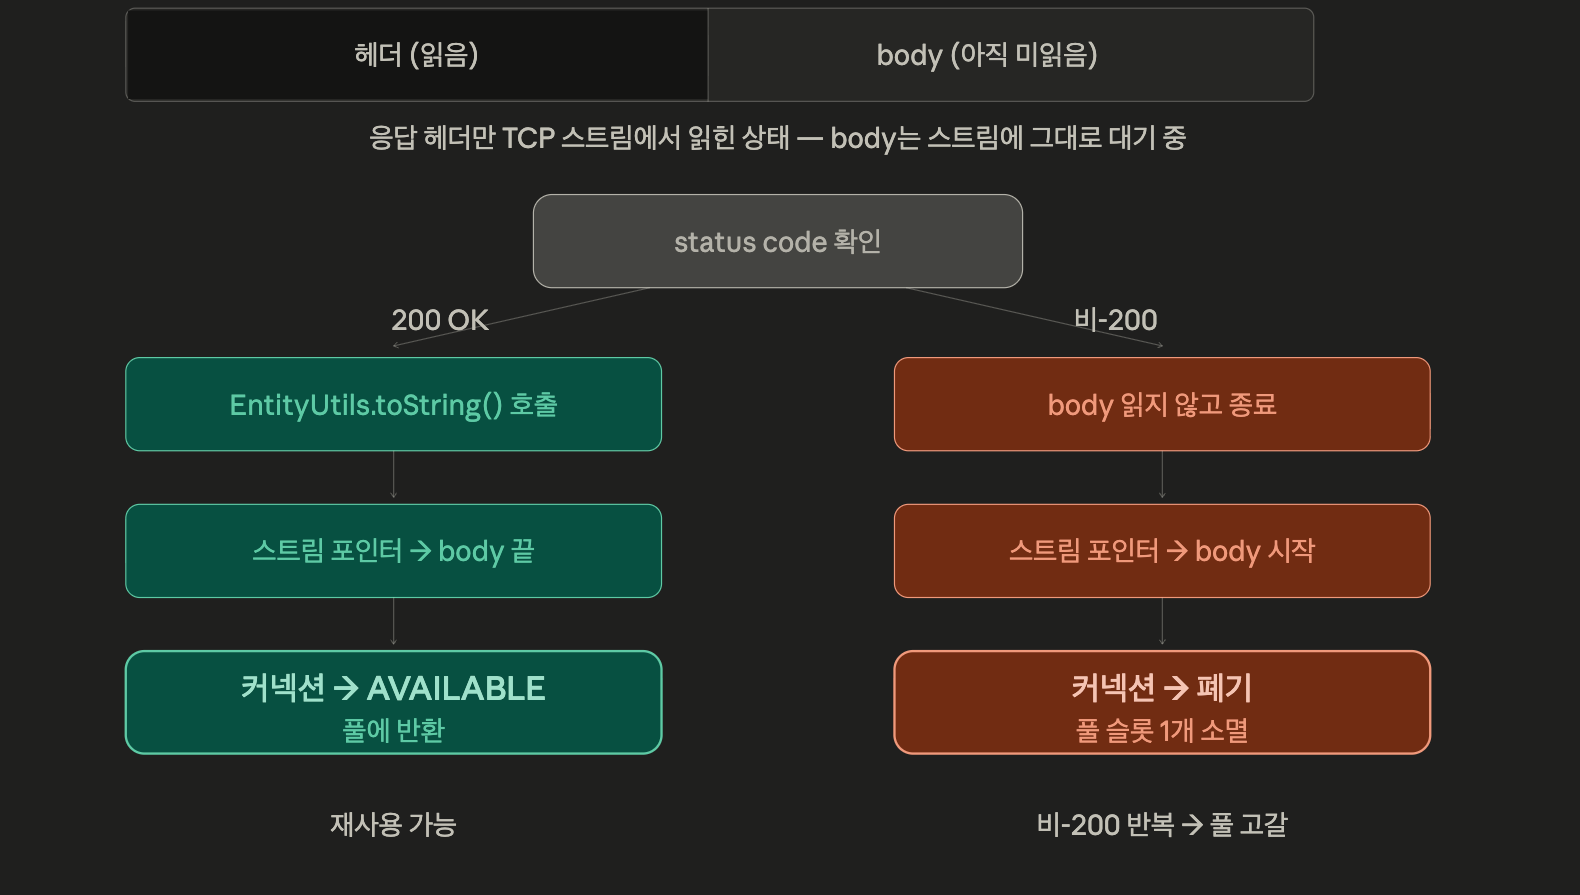
이를 lazy body 읽기 라고 부릅니다. 응답 본문은 호출자가 명시적으로 읽기 전까지는 TCP 스트림에 그대로 머물러 있습니다.
3-5. 200과 비-200의 동작 차이 (핵심)
이제 문제가 된 코드를 다시 봅니다.
response = httpClient.execute(request);
// → 이 시점: 헤더만 읽힘, body는 TCP 스트림에 대기 중

int statusCode = response.getStatusLine().getStatusCode();

if (statusCode == 200) {
    return EntityUtils.toString(response.getEntity(), StandardCharsets.UTF_8);
    // EntityUtils.toString() 내부에서 스트림을 끝까지 읽습니다.
    // 결과: TCP 스트림 포인터가 body 끝으로 이동합니다.
    // → 커넥션이 "재사용 가능한 상태" 가 됩니다.
}

// 비-200이면 여기로 옵니다.
// body는 TCP 스트림에 그대로 남아 있고, 포인터는 body 시작 지점에 멈춰 있습니다.

} finally {
    closeResponse(response);  // 내부적으로 response.close() 가 호출됩니다.
}
그렇다면 response.close() 는 어떻게 동작할까요?
Apache HttpClient의 동작 원리를 의사 코드로 단순화하면 다음과 같습니다 (실제 구현은 여러 클래스에 걸쳐 있으나 핵심 분기는 동일합니다).
// 단순화한 의사 코드입니다.
public void close() {
    HttpEntity entity = this.response.getEntity();

    if (EntityUtils.isFullyConsumed(entity)) {
        // body를 끝까지 읽었습니다 → TCP 스트림 위치가 명확합니다.
        // → 커넥션을 AVAILABLE 로 바꿔 풀에 반환합니다. ✅
        conn.setState(AVAILABLE);
        connManager.releaseConnection(conn);
    } else {
        // body를 아직 읽지 않았습니다 → TCP 스트림 위치가 불명확합니다.
        // 재사용하면 다음 요청 응답과 데이터가 뒤섞일 위험이 있습니다.
        // → 커넥션을 그냥 종료합니다 (TCP close). ❌
        conn.close();
        // 풀에서 이 커넥션 슬롯 하나가 영구히 사라집니다.
    }
}
즉, 비-200 응답이 올 때마다 커넥션이 1개씩 풀에서 사라지는 구조였던 것입니다.
3-6. 풀 고갈 시뮬레이션
이를 실제 장애 상황에 대입해 보겠습니다. 도메인당 풀 한도가 100인 상황에서 외부 API가 500을 연속 반환하는 경우입니다.
외부 API 장애 상황 (500 에러 연속 반환)

시간 0s:  풀 상태 [conn1~100 AVAILABLE]   100개
          ↓
요청  1:  conn1 LEASED → 500 응답 → body 미소비 → conn1 폐기  풀: 99개
요청  2:  conn2 LEASED → 500 응답 → body 미소비 → conn2 폐기  풀: 98개
요청  3:  conn3 LEASED → 500 응답 → body 미소비 → conn3 폐기  풀: 97개
...
요청 100: conn100 LEASED → 500 응답 → 폐기                    풀: 0개
          ↓
요청 101: 풀에 AVAILABLE 커넥션이 하나도 없습니다.
          → MaxTotal 미만이면 새 커넥션을 생성합니다 (3-way handshake 비용 발생).
          → MaxTotal 에 도달하면
            → connectionRequestTimeout 동안 대기합니다.
            → 타임아웃이 지나면 ConnectionPoolTimeoutException 이 발생합니다.
            → 로그에 에러가 찍히고, 호출자는 빈 문자열을 받게 됩니다.
여기서 더 심각한 점은, 같은 풀을 공유하는 다른 도메인의 API 호출까지 영향을 받는다는 것입니다. MaxTotal=300 전체가 잠식되면 정상 동작 중인 외부 API 호출도 모두 풀 대기에 들어가 타임아웃됩니다. 단일 외부 시스템의 장애가 전체 외부 호출 장애로 번지는 셈입니다.
4. 해결 과정 (Troubleshooting Steps)
4-1. 시도해 볼 수 있는 접근들과 한계
이런 상황에서 흔히 떠올리는 접근법들과 그 한계를 정리하면 다음과 같습니다.
| 시도 | 결과 | 한계 |
|---|---|---|
| 커넥션 풀 크기 증가 (MaxTotal 늘리기) | 일시적으로 버티는 시간만 늘어남 | 장애가 지속되면 결국 고갈됩니다. 근본 원인을 해결하지 못합니다. |
connectionRequestTimeout 증가 |
에러 발생 시점만 늦춤 | 응답 지연만 길어지고, 결국 동일한 예외가 발생합니다. |
| 재시도 로직 추가 | 풀 소진 속도만 가속 | 재시도가 다시 비-200 응답을 받으면 커넥션이 더 빠르게 폐기됩니다. 오히려 역효과입니다. |
| 외부 API 장애 시 회로 차단(Circuit Breaker) | 보조 수단으로는 유효 | 근본 원인이 "응답 본문 미소비" 인 한 차단기 복구 시점에 다시 같은 문제가 재발할 수 있습니다. |
이 모든 시도는 현상에 대한 대응 일 뿐, 본질적인 원인인 "본문을 읽지 않으면 커넥션이 반환되지 않는다" 라는 점을 해결하지 못합니다.
4-2. 최종 해결책 — EntityUtils.consume() 한 줄
근본 해결책은 의외로 간단합니다. 응답의 status code 와 무관하게, finally 블록에서 응답 본문을 항상 끝까지 읽어 주는 것 입니다. 이를 위해 Apache HttpClient는 EntityUtils.consume() 이라는 유틸을 제공합니다.
수정 전/후 비교
// [수정 전]
} finally {
    closeResponse(response);
}

// [수정 후]
} finally {
    if (response != null) {
        try {
            EntityUtils.consume(response.getEntity());  // 비-200 응답에서도 body 를 끝까지 소비합니다.
        } catch (Exception ignored) { }
    }
    closeResponse(response);
}
전체 코드 (수정 후)
public static String sendGetRequest(String url, Map<String, String> headers) {
    CloseableHttpResponse response = null;
    try {
        HttpGet request = new HttpGet(url);
        headers.forEach(request::addHeader);
        response = httpClient.execute(request);
        int statusCode = response.getStatusLine().getStatusCode();
        if (statusCode == 200) {
            return EntityUtils.toString(response.getEntity(), StandardCharsets.UTF_8);
        }
    } catch (SSLException e) {
        return "";
    } catch (Exception e) {
        log.error("sendGetRequest fail : {}", url, e);
    } finally {
        if (response != null) {
            try {
                EntityUtils.consume(response.getEntity());  // 핵심: body 소비를 강제합니다.
            } catch (Exception ignored) { }
        }
        closeResponse(response);
    }
    return "";
}
EntityUtils.consume() 이 하는 일
EntityUtils.consume() 의 동작을 의사 코드로 표현하면 다음과 같습니다 (실제 구현은 1바이트씩 읽는 것이 아니라 내부 버퍼를 사용해 chunk 단위로 읽지만, 개념은 동일합니다).
// 단순화한 의사 코드입니다.
public static void consume(HttpEntity entity) throws IOException {
    if (entity == null) return;
    if (entity.isStreaming()) {
        InputStream instream = entity.getContent();
        // body 를 끝까지 읽어서 버립니다.
        // 읽은 내용은 사용하지 않고, 오직 스트림 포인터를 끝으로 이동시키는 것이 목적입니다.
        while (instream.read() != -1) { }
        instream.close();
    }
}
이 호출 이후 TCP 스트림의 상태는 다음과 같이 변합니다.
TCP 스트림
────────────────────────────────────────────────→

[응답 헤더 ✅읽음] [응답 Body ✅읽음(버림)]
                                              ↑
                                    스트림 포인터 (body 끝)
                                    → 커넥션 재사용 가능 상태
이제 response.close() 시점에 EntityUtils.isFullyConsumed() 검사가 true 가 되어, 커넥션은 폐기되지 않고 AVAILABLE 상태로 풀에 반환됩니다.
4-3. 수정 후 기대되는 효과
같은 장애 상황을 다시 돌려 보면 결과는 완전히 달라집니다.
외부 API 장애 상황 (500 에러 연속 반환) — 수정 후

시간 0s:  풀 상태 [conn1~100 AVAILABLE]   100개
          ↓
요청  1:  conn1 LEASED → 500 응답 → body 소비(버림) → conn1 반환  풀: 100개
요청  2:  conn1 LEASED → 500 응답 → body 소비(버림) → conn1 반환  풀: 100개
요청  3:  conn1 LEASED → 500 응답 → body 소비(버림) → conn1 반환  풀: 100개
...
→ 풀 크기가 그대로 유지되며 ConnectionPoolTimeoutException 도 발생하지 않습니다.
일반적으로 이 수정을 적용한 뒤 관찰되는 지표는 다음과 같습니다.
- 풀 사용량 그래프 안정화: 외부 API 장애가 지속되어도 LEASED/AVAILABLE 카운트가 정상 범위를 벗어나지 않습니다.
- 커넥션 생성/폐기 카운트 감소: 신규 TCP handshake 비용이 줄어 응답 지연이 개선됩니다.
- 연쇄 장애 사라짐: 특정 외부 API 의 장애가 동일 인스턴스에서 호출하는 다른 외부 API 에 영향을 주지 않습니다.
5. 학습 및 회고 (Lesson Learned & Next Steps)
원인 한 줄 요약
HTTP 응답 본문을 끝까지 읽지 않으면 Apache HttpClient 는 TCP 스트림 포인터가 어디 있는지 알 수 없어 해당 커넥션을 폐기합니다. 이로 인해 비-200 응답이 반복되면 풀이 빠르게 고갈됩니다.
조금 더 직관적으로 정리하면 이렇습니다.
TCP 스트림은 연속된 바이트 흐름이라, Body 를 끝까지 읽어야 "다음 통신 시작점" 을 알 수 있습니다. Apache HttpClient 는 이 위치를 모르면 커넥션을 안전하게 재사용할 수 없으므로 그냥 버려 버립니다.
개선 사항
EntityUtils.consume()호출을 모든 HTTP 클라이언트 유틸의 finally 블록에 강제합니다.- 응답을 사용하든 사용하지 않든, status code 가 무엇이든 일관되게 본문을 소비하도록 합니다.
- 사내 공통 HTTP 유틸이 있다면 이 패턴이 누락된 곳이 있는지 전수 점검합니다.
- 커넥션 풀 메트릭을 모니터링 시스템에 추가합니다.
PoolingHttpClientConnectionManager.getTotalStats()로 노출되는 LEASED/AVAILABLE/PENDING 카운트를 지표로 수집합니다.- 도메인별 (
Route별) 풀 사용량도 함께 추적하면 어느 외부 API 가 풀을 잠식하는지 즉시 파악할 수 있습니다.
- 자원 회수 패턴을 코드 리뷰 체크리스트에 추가합니다.
try-with-resources사용 가능한 곳은 적극 활용합니다 (CloseableHttpResponse는AutoCloseable입니다).- 다만
try-with-resources만으로는 본문 소비가 강제되지 않으므로, 본문 처리 책임을 별도로 명시합니다.
- Apache HttpClient 5.x 마이그레이션 검토.
- 5.x 에서는 응답 처리 API 가 람다 기반(
HttpClientResponseHandler)으로 개선되어 본문 소비를 잊기 어려운 구조로 바뀌었습니다. 장기적인 안정성을 위해 마이그레이션을 검토해 볼 만합니다.
- 5.x 에서는 응답 처리 API 가 람다 기반(
- 외부 API 호출에 Circuit Breaker 도입.
- 본 이슈의 근본 원인은 해결되었지만, 외부 API 장애 자체로부터 시스템을 보호하기 위한 보조 장치로 Circuit Breaker (Resilience4j 등) 를 함께 도입하면 안정성이 한층 더 올라갑니다.
마치며
이번 사례는 "코드 한 줄 누락" 이 어떻게 시스템 전체에 연쇄적인 영향을 미칠 수 있는지를 잘 보여줍니다. 라이브러리가 추상화해 둔 "커넥션 풀" 이라는 개념도, 그 아래의 TCP 스트림 구조와 HTTP 라이브러리의 lazy 읽기 동작을 이해해야 비로소 진짜 원인이 보입니다.
라이브러리를 단지 사용만 하는 것이 아니라, 그 라이브러리가 자원을 어떻게 관리하는지 를 한 번씩 들여다보는 습관이 비슷한 장애를 예방하는 가장 확실한 방법이라고 생각합니다.
'[TIL]' 카테고리의 다른 글
| [TIL] EHcache 캐시 오염 트러블슈팅 - 캐시 객체 (0) | 2026.06.27 |
|---|---|
| [TIL] Class 핫리로드와 톰캣의 오해 - 톰캣이 올라오고 class 파일을 교체해도 적용될까? (0) | 2026.06.16 |
| 트러블슈팅 - OpenFeign과 @Configuration: 빈 등록의 함정과 FeignContext의 이해 (0) | 2025.10.17 |
| TIL - CDC로 향하는 가는 첫 번째 과정(1) : OracleDB 트랜잭션 로그(Redo log)를 읽어서 Kafka에 적재하기 (0) | 2025.01.10 |
| [ TIL ] RECOVER_YOUR_DATA : RDS 해킹 일지 (1) | 2024.11.13 |